ХАКАТОН «ИИ-АССИСТЕНТЫ ДЛЯ ЭНЕРГЕТИКИ»
Судебный ассистент
Судебные приказы, исполнительные листы и постановления ФССП превращаются в таблицу по образцу и письмо юристу
PDF · сканы · Word · XML ФССП · YandexGPT с проверкой цитат
F1 0,80 на документах, которых система не видела
ЗАДАЧА
Сотрудники вручную переносят реквизиты из судебных документов в таблицу
Судебный приказ
Бумажный скан или электронная форма ФССП. Должники, адрес, дело, период, долг, пени, пошлина.
Исполнительный лист
PDF с текстовым слоем или многостраничный скан. Карточка должника, паспорт, ИНН, соответчики.
Постановление ФССП
XML с вложенными сведениями об исполнительном производстве и парный PDF.
Нужно: определить тип, извлечь поля по образцу, отметить пропуски, сохранить в XLSX/CSV и переслать юристу акты, которые требуют его работы.
2
ЧТО ДЕЛАЕТ ПРОТОТИП
Пять шагов от файла до письма
01
Чтение
Слой PDF, OCR Yandex Vision или Tesseract, Word, XML ФССП
02
Тип
Приказ или ИЛ — по правилам, «эл» — правила и модель
03
Извлечение
Правила и обученная модель, 22 поля судов и 24 ФССП
04
Проверки
Сверка сумм, ИНН, дат, источников
05
Результат
XLSX и CSV, письмо юристу с PDF и причинами
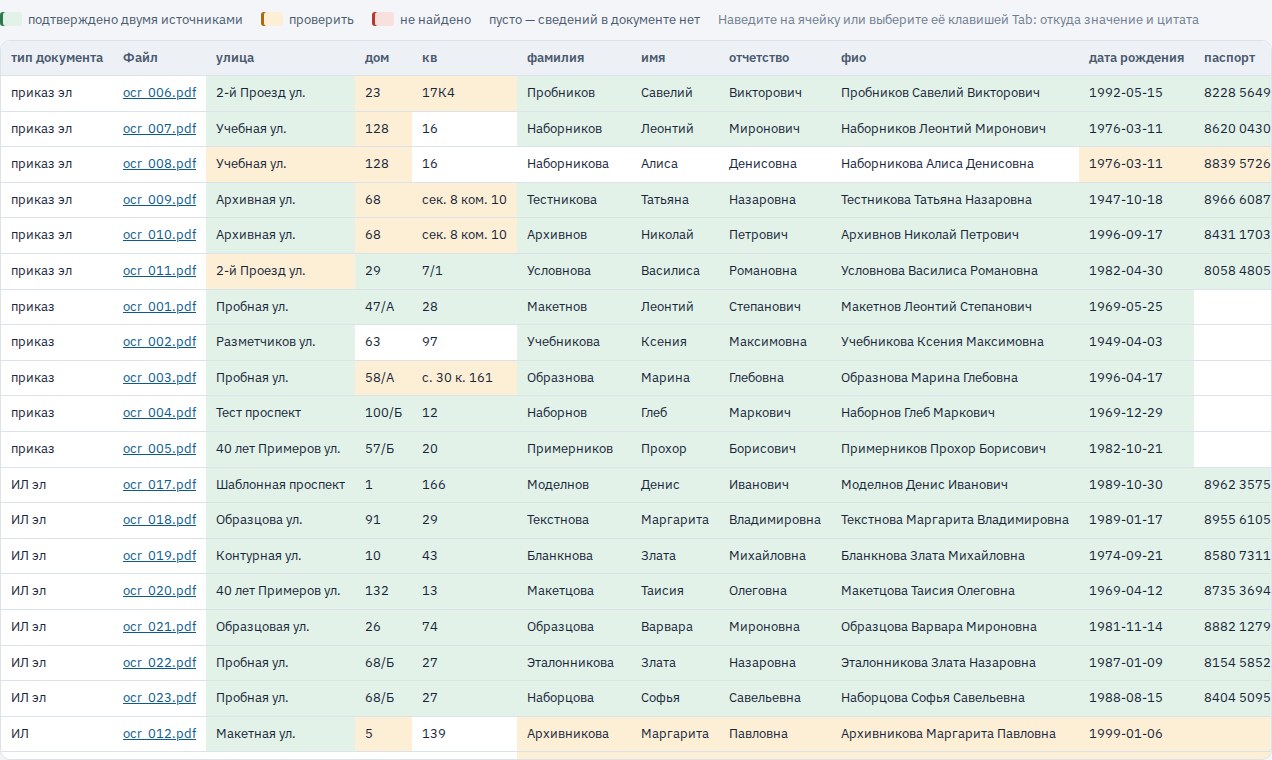
Веб-интерфейс и командная строка. Чего нет — ячейка красная; в чём сомнение или что нашла только модель — жёлтая, с замечанием.
3
ТЕХНИЧЕСКИЙ ПОДХОД · 1
Двойное чтение: слой PDF и OCR проверяют друг друга
Два источника
Даже при наличии текстового слоя документ распознаётся заново. Расхождение по ключевому полю становится замечанием.
Второй проход
Не хватает обязательного поля в скане — OCR в режиме разреженного текста находит оторванные даты и строки.
Починка шума
«!0 538» → 10 538, склейки «пошлиныв», «периодс», разорванное «м есто жительства».
ocr_020: слой потерял «40 коп.», OCR их увидел — взята сумма с копейками
ocr_002: второй проход вернул дату приказа, адрес и период
4
ТЕХНИЧЕСКИЙ ПОДХОД · 2
Правила и обученная модель дополняют друг друга
Правила
Точны на знакомых формах: ФИО и падеж, суммы, соответчики. На незнакомой форме чаще оставляют поле пустым.
Модель: ансамбль из трёх CRF
Размечает слова в тексте по полям. Сильнее в номере и дате дела, периоде, паспорте, СНИЛС, ИНН.
Порядок по полям выбран на проверочных данных: номер и дата дела, период — сначала модель; пени — только правила; остальное — правила, пустое дополняет модель
Жёлтая ячейка: значение нашла только модель или правила и модель расходятся — юрист видит оба варианта
5
ЯНДЕКС AI STUDIO
Языковая модель — третий голос, который нужно доказать
- YandexGPT возвращает по каждому полю значение и дословную цитату (JSON по схеме)
- Код проверяет: цитата есть в документе, значение — в цитате, формат, слово поля
- Не прошло проверку — модели на исправление, потом отбрасывается
- Знакомая форма — правила главнее, модель подтверждает. Незнакомая — при расхождении побеждает модель с цитатой, ячейка жёлтая
Модели меняются одной строкой: LLM_MODEL (YandexGPT Pro/Lite, Qwen3, gpt-oss) и OCR_ENGINE (Yandex Vision OCR или Tesseract)
ЖИВОЙ ПРОГОН, 103 ДОКУМЕНТА
| Набор | Без модели | Только модель | Итог |
|---|---|---|---|
| Учебный, 23 | 0,984 | 0,925 | 0,984 |
| Новые формы А, 40 | 0,834 | 0,949 | 0,957 |
| Новые формы Б, 40 | 0,776 | 0,961 | 0,964 |
Правило «кому верить» выбрано на наборе А и проверено на Б и учебном. Итог точнее и правил, и модели по отдельности; на учебном наборе ничего не потеряно.
6 · yandexgpt-5.1 и Yandex Vision OCR · ответы кэшируются: повторный прогон бесплатный и воспроизводимый
ТЕХНИЧЕСКИЙ ПОДХОД · 3
Модель учится только на сгенерированных документах
Генератор
Бланки «метка / значение», должники в падежах, суммы прописью, неполный период, даты-ловушки. Каждое значение размечено при сборке.
Шум 0–3
Переносы строк, латиница внутри слов, путаница OCR («Ангону»), пропуски знаков, строки «КОПИЯ ВЕРНА», «- 2 -».
Свежие данные
Каждая модель ансамбля — на своей выборке из 1 500 документов. Реальные документы в обучение не попадают.
Абляция: каждое нововведение генератора проверено отдельно; реквизиты соответчиков (−0,027) и заявленные суммы (−0,009) ухудшали результат и выключены
7
ТЕХНИЧЕСКИЙ ПОДХОД · 4
Проверки, которые сделал бы юрист
| Проверка | Как | Нашла в наборе |
|---|---|---|
| Итог сходится | Итог «на сумму» равен сумме части указанных сумм | ocr_020: не сходится |
| ИНН должника | Карточка должника против цитаты акта | ocr_020: два разных ИНН |
| Дата рождения, пол | Карточка против текста; пол против отчества | ocr_008: противоречие |
| Должники в бланке ИЛ | Резолюция против блока «Должник» | ocr_014: разные люди |
| XML против PDF | Номер ИП, номер ИД и сумма совпадают в паре файлов | fssp_009: сумма в PDF вдвое меньше |
| Сводное ИП | Вложенные производства и другие должники | fssp_010: второй должник |
| Дата дела | Не совпадает с датой вступления в силу или выдачи | совпала — жёлтая ячейка |
Противоречие из README набора (ИНН в ocr_020) прототип нашёл сам. В таблицу пишется значение из карточки, как требует образец, а расхождение уходит юристу.
8
КОГДА НУЖЕН ЮРИСТ
Каждое решение объяснено словами
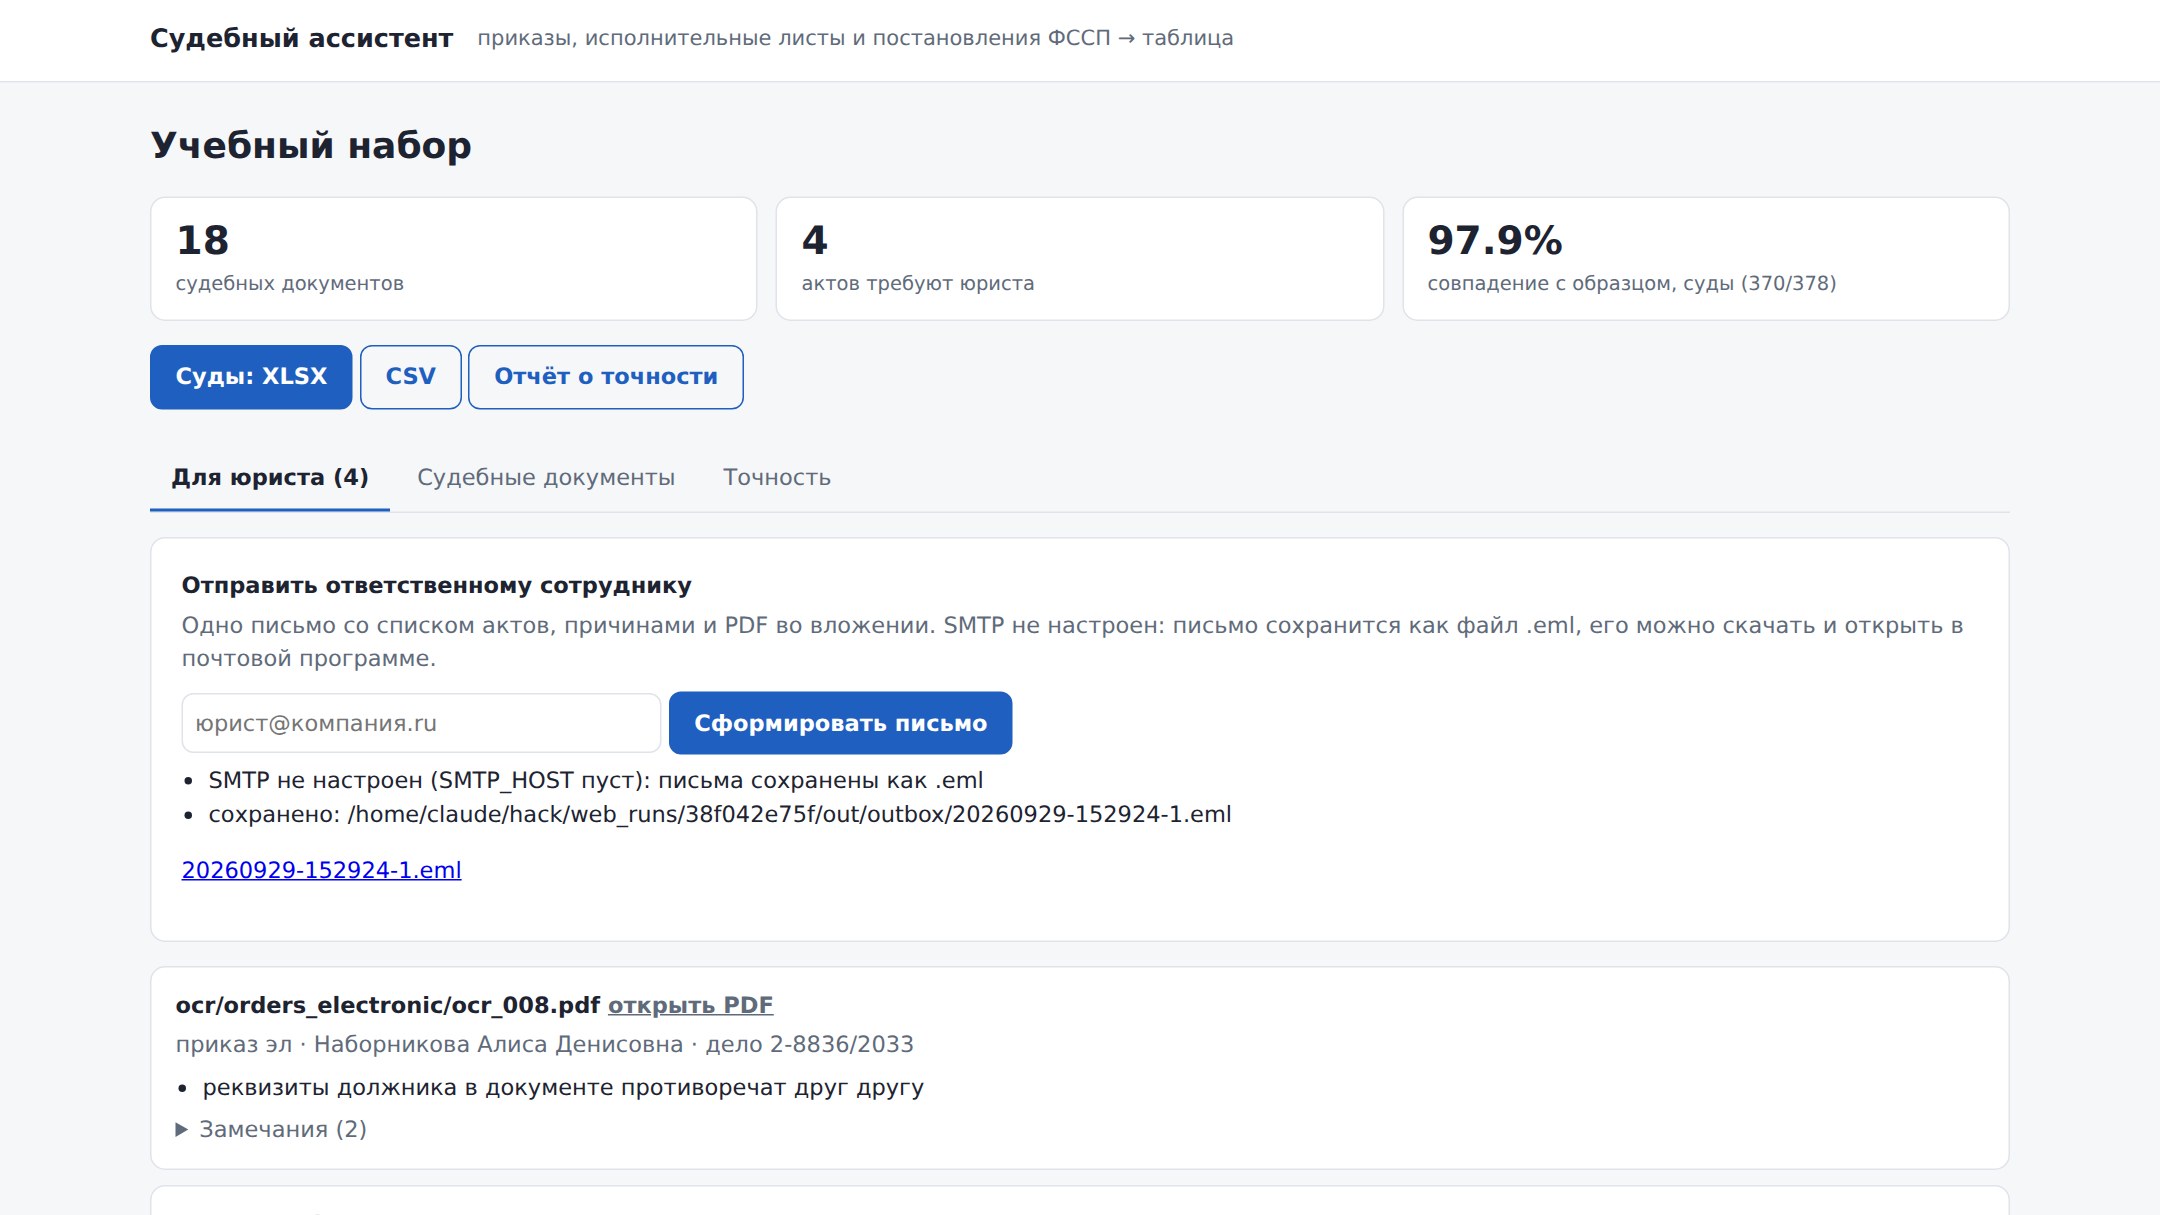
Причина видна в таблице, в веб-интерфейсе и в письме. Юристу приходит одно письмо: список актов с причинами и деталями, PDF и таблица XLSX во вложении.
8 из 23
судебных актов и 15 из 21 постановления ФССП на учебном наборе
Судебные документы
- не извлечено обязательное поле
- слой и OCR читают поле по-разному
- итог не сходится, реквизиты противоречат
- прежняя фамилия, 5+ должников
- низкая уверенность OCR (меньше 70%)
Постановления ФССП
- отказ в возбуждении ИП
- ИД возвращён взыскателю
- ИП прекращено
- XML расходится с парным PDF
9
ОТБОР ЮРИСТУ
Фразы-маркеры заказчика: 11 актов из 11
- «…» во фразе — пропуск: «Исковое заявление ПАО … к Иванову … оставить без движения»
- Слова по основе: «государственной пошлины» = «государственную пошлину»
- Глаголы строго: «отменить» ≠ «отменён» — иначе фраза ловит каждый приказ
- Перефразировки ищет модель, с цитатой и проверкой
| Проверка | Результат |
|---|---|
| 11 актов-примеров, текстовый слой | 11 / 11 |
| Те же акты как сканы (OCR) | 11 / 11 |
| Ложные срабатывания на 239 приказах и листах | 0 |
| Вид акта: решение, определение, постановление | 11 / 11 |
В письме юристу — фраза и цитата из акта: «Оставить иск без рассмотрения», «Производство по делу прекратить».
10 · перечень заказчика: data/markers.txt, правится без кода · тест на каждую фразу
КАК МЫ ПРОВЕРЯЛИ КАЧЕСТВО
Только на документах, которых система не видела
01
Фиксация
Версия кода и моделей закреплена тегом в git
02
Новый набор
Отдельный агент без доступа к коду: 40 документов, 13 шаблонов, 20 сканов
03
Один прогон
Без правок; после него набор считается увиденным
04
Метрики
micro-F1 по ячейкам, поля, ошибки без пометки, бутстреп
На документах разработки правила давали 0,96, на новых — около 0,70. Поэтому главная цифра считается только на новых данных.
11
РЕЗУЛЬТАТ · СУДЕБНЫЕ ДОКУМЕНТЫ
0,79
тест: видит
впервые, 60 док.
0,90
тренировочные,
278 док.
Средний micro-F1 по наборам. Разрыв 0,11; у версии на одних правилах был 0,25.
XML ФССП на независимой синтетике: 0,93
| Набор | Док. | F1 |
|---|---|---|
| Обучающие документы генератора | 150 | 0,923 |
| Реальные учебные документы | 23 | 0,958 |
| Проверочная синтетика | 105 | 0,83–0,92 |
| Тест: документы с текстом | 40 | 0,803 |
| Тест: сканы | 20 | 0,773 |
12 · micro-F1 по ячейкам без учёта оформления · тест — новый набор от независимого генератора, один прогон
ПРОГРЕСС ПО ВЕРСИЯМ
Все версии — на одном и том же новом наборе
| Версия | F1, текст | F1, сканы | Ошибок из 840 | Без пометки |
|---|---|---|---|---|
| Только правила | 0,704 | 0,688 | 303 | 146 |
| Раунд 1: + обученная модель | 0,771 | 0,741 | 220 | 63 |
| Раунд 2: + ансамбль, даты | 0,803 | 0,773 | 191 | 52 |
Значимо: раунд 2 лучше раунда 1 на +0,033, 95% интервал от +0,018 до +0,049; лучше в 20 документах, хуже в 5, p = 0,004
Цена: неверных значений у связки больше, чем у правил (91 против 64), но большая часть помечена жёлтым
13
ПЕРЕОБУЧЕНИЕ
Снижение мощности модели разрыв не закрывает
| Признаков модели | Обучение | Новые документы генератора | Независимый тест |
|---|---|---|---|
| 120 тысяч | 0,963 | 0,954 | 0,650 |
| 3,9 тысячи (выбрана) | 0,963 | 0,952 | 0,684 |
| 2,6 тысячи, без словаря | 0,936 | 0,931 | 0,519 |
Модель не заучивает примеры: на новых документах генератора качество как на обучающих
Разрыв — сдвиг распределения: в генераторе нет части реальных форм; помогают разнообразие данных, ансамбль и связка с правилами
14 · одна модель без правил, тест раунда 1; мощность выбрана по проверочным данным
ГДЕ ОШИБКИ СЕЙЧАС
Тест: 191 неверная ячейка из 840
| Поле | Верно | Почему ошибается |
|---|---|---|
| Дом | 0,43 | Корпус и литера в разной записи; часть — условность «12/2» или «12К2» |
| Дата дела | 0,63 | Рядом даты вступления в силу, выдачи, начала периода |
| Улица | 0,73 | Сельские адреса, нестандартные типы улиц |
| ФИО | 0,75 | Несклоняемые фамилии, ФИО только в косвенном падеже |
| Суммы | 0,88–0,95 | Надёжно: долг, пени, пошлина |
По видам: 71 пропуск, 91 неверное значение, 29 лишних
Без жёлтой пометки: 52 ячейки — 6% таблицы
15
ГДЕ ОШИБКИ
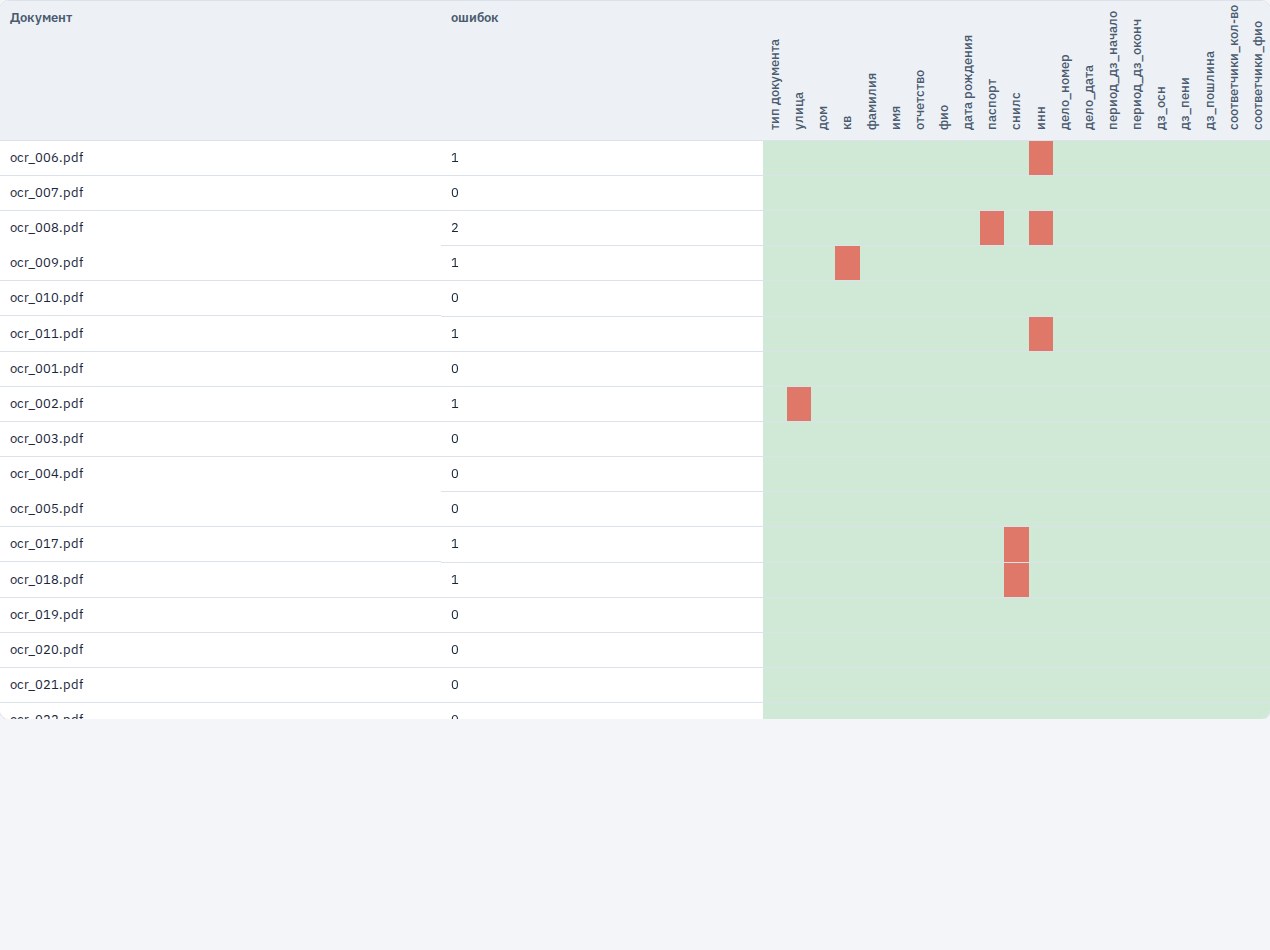
Карта: документ × поле
Строится в интерфейсе по таблице ответов. Наведение — что получено и что ожидалось.
Карта показала: 15 из 21 ошибки — выбор основного должника в листах с несколькими должниками. Оказалось, он отмечен на бланке рукописной галочкой. Ассистент теперь её находит: ошибок 21 → 7, точность 0,952 → 0,984.
Оставшиеся 7 — расхождения с условностями разметки: СНИЛС в образце не заполняется ни разу, ИНН — не везде.
Светофор доверия
зелёный — подтверждено двумя источниками · жёлтый — проверить · красный — не найдено
Интерфейс: акты для юриста
кнопка → письмо с PDF и таблицей
ЭКОНОМИКА
Сотрудник проверяет, а не набирает
77%
ячеек заполнено без человека
23%
ячеек — на проверку, все отмечены цветом
≈75 ч
экономии на 1000 документов
5 600
токенов модели на документ (3 запроса)
Расчёт виден в интерфейсе после каждой обработки. Допущения — в настройках: ручной ввод 6 мин на документ, проверка жёлтой ячейки 20 с, заполнение пропуска 40 с. Юрист получает только акты с причиной и цитатой, остальное — в таблицу.
19 · учебный набор, 23 судебных документа, yandexgpt-5.1 · стоимость в рублях считается по тарифу AI Studio, если его указать
ИНСТРУМЕНТЫ
Открытые библиотеки и модели — и для чего
| В работе прототипа | Для чего |
|---|---|
| Yandex Vision OCR · Tesseract 5 | Распознавание сканов; Tesseract — запасной |
| PyMuPDF | Слой PDF, страницы в картинки |
| sklearn-crfsuite | Модель полей, ансамбль из 3 |
| scikit-learn | Вид документа: TF-IDF + логрегрессия |
| rapidfuzz | Нечёткие заголовки, ошибка OCR |
| openpyxl, xlrd | XLSX с подсветкой, разметка XLS |
| Flask, Docker, Caddy, Postfix | Веб-сервис, HTTPS, своя почта |
| YandexGPT 5.1 (AI Studio) | Третий источник с цитатами, маркеры по смыслу |
| В разработке и проверке | Для чего |
|---|---|
| Python: re, xml, zipfile | Правила, XML ФССП, Word, ODF |
| smtplib, email | Письмо юристу или файл .eml |
| python-docx, reportlab | Синтетические DOCX и PDF |
| LibreOffice | Конвертация в PDF для тестов |
| pytest, pyflakes | 132 теста, статическая проверка |
| git, git worktree | Фиксация версий для оценки |
| Claude (Anthropic) | Код; отдельные агенты — тесты |
20 · внешние модели — только Yandex AI Studio (российское облако); без них ассистент работает локально
КОД
Понятный код, который легко править вручную
- Модуль на каждый шаг: чтение, тип, поля, проверки
- Модель включается и выключается настройкой
- 132 теста, регресс по учебному набору
- Всё работает локально, без видеокарты
Где что менять
config.py — колонки, обязательные поля
review.py — правила «нужен юрист»
claim.py — формулировки сумм
address.py — типы улиц
fssp.py — теги XML
learn/gen.py — формы для обучения
learn/hybrid.py — правила или модель
tools/train_model.py — переобучить
tools/blind_eval.py — слепая оценка
21
ОГРАНИЧЕНИЯ
Что важно знать
- Тест синтетический: на реальном потоке результат может отличаться
- На незнакомой форме документа качество около 0,8, не 0,96
- Модель чаще ошибается значением, чем правила, — такие ячейки жёлтые
- Основной должник в листе с несколькими должниками — по правилу заказчика (сейчас первый)
ДАЛЬШЕ
Этап 2
- Разметить 100–200 реальных документов и замерить качество на них
- Дообучение YandexGPT Lite в AI Studio на размеченных реальных актах
- Пометка по уверенности модели: ошибок без пометки меньше 5%
- Журнал правок юриста — новые формы для генератора
22